
Voici comment cela fonctionne : Analyse intelligente
Tous les systèmes de mémoire de traduction analysent vos textes et calculent un « nombre de mots pondérés » (Weighted Word Count, WWC). Comment cela fonctionne-t-il ?
Le principe de fonctionnement est de constituer puis d’utiliser une mémoire de traduction (TM). Il s’agit d’une base de données où sont stockées les traductions précédentes. Elle est mise à jour automatiquement et est complétée au cours de la traduction.
Un texte est constitué de « segments ». Dans le cas le plus simple, il s’agit de phrases. Mais il peut aussi s’agir de titres, de cellules de tableaux, d’entrées de menus de logiciels, etc.
Lors de l’analyse, les segments du nouveau texte sont comparés aux segments de la mémoire de traduction et la similarité est calculée. Voici un exemple :
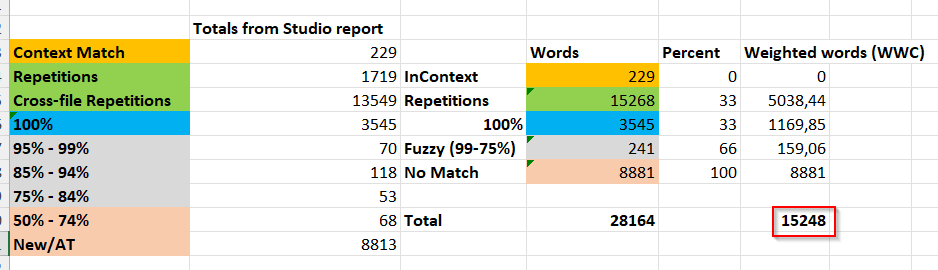
Le texte à traduire contient au total 28 164 mots. Vous ne devez payer que pour 15 248 mots. Comment cette valeur est-elle déterminée ?
Le tableau présente les différentes catégories de correspondances (« taux de correspondance », « match rate ») :
Context Match (Correspondance de contexte) : Il y a concordance de contexte lorsqu’il y a au moins trois segments (ex : 3 phrases) consécutifs identiques avec une traduction précédente contenue dans la bibliothèque (TM). On peut donc supposer qu’il n’y a plus rien à modifier dans ces traductions. Les mots qu’elles contiennent ne sont donc pas comptés (Pourcentage = 0).
Répétitions : Il s’agit des mots qui se répètent dans les segments non traduits. Si, par exemple, la phrase « We look forward to see you » apparaît vingt fois dans un texte, six mots sont comptés comme nouveaux une fois et 19 × 6 mots à 33 % seulement. Pourquoi payer pour ces répétitions ? C’est très simple : Selon le contexte, la traduction peut devoir être différente.
Cross-file Repetitions (Répétitions entre fichiers) : Si le même segment apparaît dans plusieurs fichiers à traduire, il entre dans cette catégorie. Il est traité de la même manière que les répétitions ordinaires. La valeur est purement statistique.
100%: Segments dont la traduction figure déjà dans la (TM). Ils doivent cependant être vérifiés car la traduction ne peut être garantie dans le contexte concerné. Un exemple (purement fictif) : Dans le texte anglais, il est dit dans un titre et dans une liste : « Switching on the machine ». En français, le titre doit être « Mise en marche de la machine » et dans la liste « Mettre la machine en marche »
Les catégories grises entre 99% et 75% se réfèrent à des segments similaires à des segments déjà traduits. Ils peuvent bénéficier d’un prix réduit.
La dernière catégorie comprend tous les segments qui s’écartent considérablement des traductions de la TM ou qui sont complètement nouveaux (pas de correspondance). Ils seront facturés au prix de base du mot.